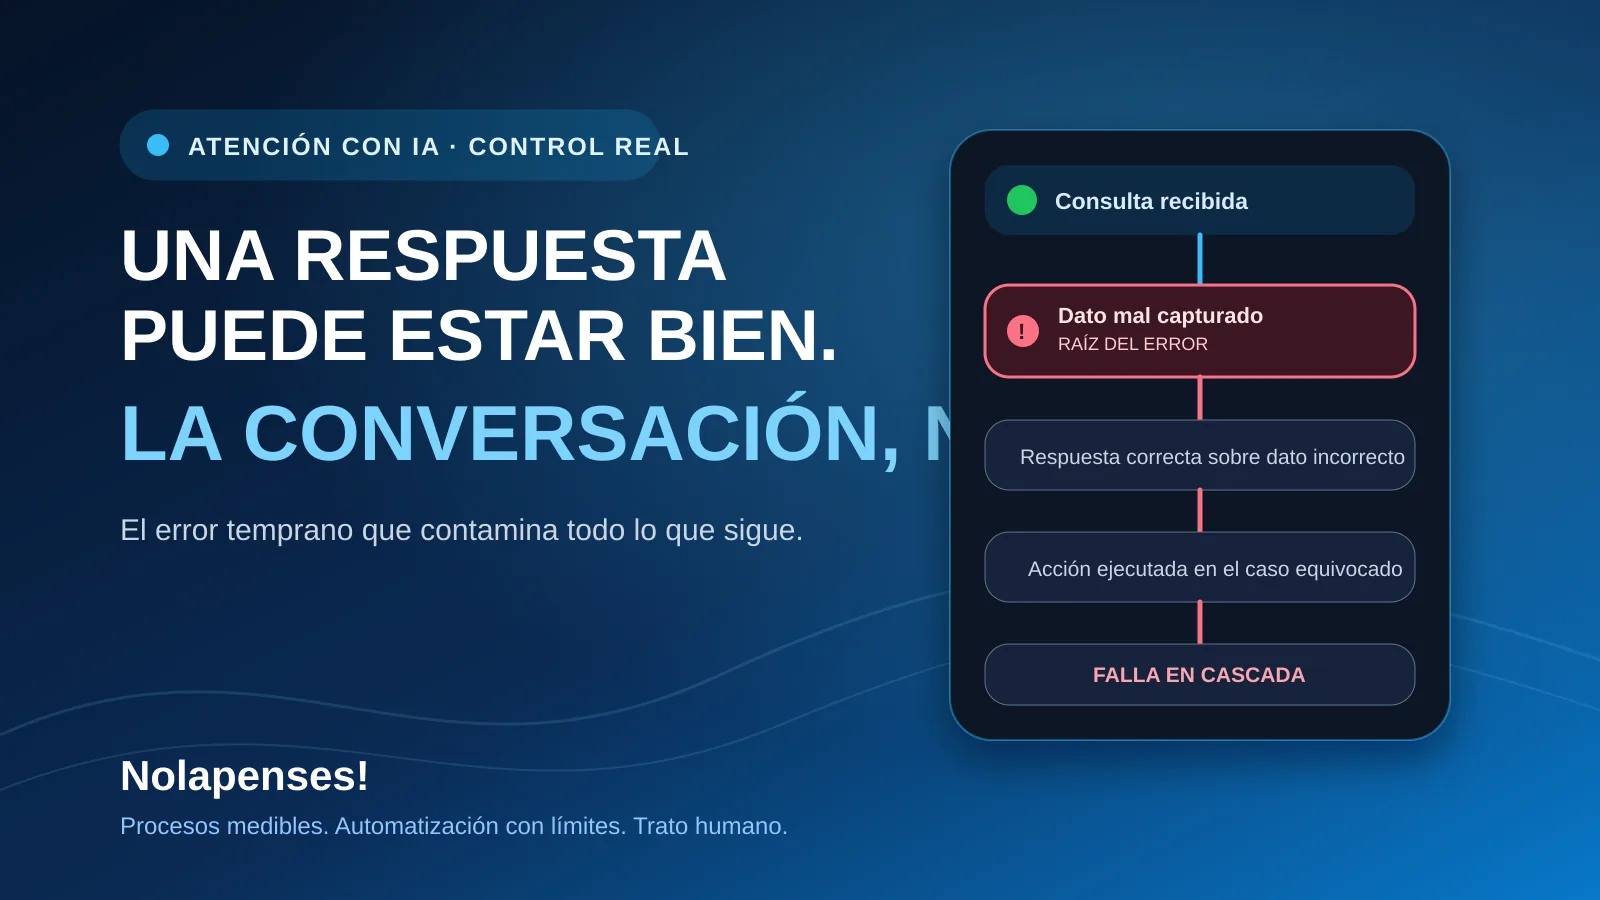
Probar si un asistente responde bien una pregunta no alcanza. En una conversación real, cada respuesta depende de lo que pasó antes. Si el sistema interpreta mal una fecha, una zona, un producto o la intención del cliente, puede seguir contestando con coherencia y ejecutar el paso equivocado.
Ahí está el riesgo: el mensaje parece prolijo, pero el proceso ya quedó torcido. El error original se disfraza detrás de varias respuestas razonables y el equipo termina mirando el desenlace en vez de revisar dónde empezó el problema.
La unidad de prueba tiene que ser la conversación
AWS publicó el 10 de septiembre de 2026 una propuesta llamada Agent Evaluation Metric (AEM) para evaluar agentes en conversaciones de varios turnos. En lugar de quedarse con una nota global, separa la corrección en dos aspectos: si la información es consistente y si están presentes todos los elementos necesarios.
El enfoque revisa tanto las respuestas como las acciones. En una llamada a una herramienta, por ejemplo, puede distinguir entre elegir la herramienta equivocada, omitir un parámetro o enviar un valor incorrecto. También identifica el primer turno que falló y diferencia esa causa de los errores posteriores que heredaron el problema.
La publicación técnica de AWS sobre evaluación de conversaciones multi-turno explica que una sola llamada incorrecta puede propagarse por toda la interacción. Su ejemplo usa un informe comercial: el agente envía “ganancia” cuando debía consultar “ingresos” y los pasos siguientes trabajan sobre ese dato equivocado.
Cómo se ve esto en una atención comercial
Imaginemos una consulta por WhatsApp. La persona pide un turno para una sucursal, aclara un horario y después confirma. Si el asistente tomó mal la sucursal en el primer intercambio, puede verificar disponibilidad, pedir datos y enviar una confirmación perfectamente redactada para el lugar equivocado.
Evaluar solamente el último mensaje diría poco. Lo que conviene revisar es la trayectoria completa: qué dato pidió, qué dato entendió, qué sistema consultó, qué acción intentó y en qué momento una persona debía intervenir.
Qué debería medir un negocio antes de escalar
- Datos requeridos: si el flujo pidió y validó la información mínima antes de avanzar.
- Primera falla: el turno exacto donde apareció el desvío, no solo el resultado final.
- Acciones: si usó la herramienta correcta con los parámetros correctos.
- Dependencias: qué respuestas posteriores quedaron contaminadas por un error previo.
- Casos críticos: qué errores exigen aprobación o revisión humana.
- Regresiones: si un cambio de modelo, instrucciones o integración empeoró conversaciones que antes funcionaban.
AWS plantea construir referencias esperadas por turno y revisarlas con datos anotados o controlados por personas. No hace falta copiar todo el marco técnico para empezar: alcanza con guardar conversaciones representativas, marcar el resultado correcto y repetir la prueba cada vez que cambia el flujo.
La decisión que importa
Antes de sumar volumen, probá conversaciones completas. Incluí ambigüedades, correcciones del cliente, datos faltantes, cambios de idea y situaciones que deben derivarse. Si el sistema solo funciona cuando todo llega limpio y en orden, todavía no está listo para representar al negocio.
La IA puede ayudar a responder, pedir datos y ejecutar tareas repetitivas. La confianza aparece cuando también podés demostrar dónde acertó, dónde falló y cuándo frenó para que interviniera una persona.
¿Querés aplicar algo parecido en tu empresa?
En Nolapenses podemos ayudarte a bajar esta idea a un flujo real de trabajo, con automatización, integración y derivación humana cuando hace falta.